経営企画やIRの現場では、毎期の業界横断ベンチマークに多くの手作業がかかっています。自社と競合、さらに異業種の先進企業まで並べて財務比率やESG指標を比べる作業です。結論から言うと、Claude Code に任せるべきなのは公開データの取得、クレンジング、異常値の洗い出し、ダッシュボードの下書きまでです。数値の解釈と経営判断は人が持つ、という役割分担にすると、精度とスピードを両立しやすくなります。
本記事では、公開データソースの選び方から、指標定義の標準化、異常値検知、可視化ダッシュボードの生成まで、実務の流れに沿って説明します。数値はあくまで参考値として扱い、どこに解釈の落とし穴があるかもあわせて書きます。
この記事で分かること
- 業界横断ベンチマークで Claude Code に任せる工程と、人が持つべき工程の分け方
- 財務データ・統計データ・ESGデータの公開ソースを選ぶときの判断基準
- 会計基準や決算期の違いを吸収する指標定義の標準化とクレンジングの手順
- 異常値検知の代表的な手法と、検知結果を読むときの留意点
- 企業で導入するときの権限設計・データの扱い・体制の考え方
本記事の結論: Claude Code は「取得・整形・検知・可視化の下書き」を担い、指標定義の承認と数値の解釈は経営企画が持つ。この分担を CLAUDE.md と手順書に明文化することが、業界横断ベンチマークを再現性のある業務にする近道です。
業界横断ベンチマークの全体像と Claude Code の役割
なぜ業界横断の比較は手間がかかるのか
同業他社だけの比較なら、業界団体の資料やアナリストレポートで足りることもあります。しかし経営企画やIRが問われるのは、たとえば「資本効率は異業種の高収益企業と比べてどうか」「人的資本の開示水準は市場全体のどこにいるか」といった、業界の枠を越えた問いです。
業界をまたぐと、比較の前提がそろわなくなります。決算期は3月期と12月期が混在し、会計基準は日本基準・IFRS・米国基準に分かれます。セグメントの切り方も企業ごとに違います。ESG指標に至っては、同じ「温室効果ガス排出量」でも対象範囲や算定方法が異なります。これを毎期 Excel で手修正していると、担当者が替わった途端に再現できなくなります。私が支援の現場で見てきた中でも、つまずくのは分析そのものより「前処理の属人化」であることが多いと感じています。
Claude Code に任せる工程・人が持つ工程
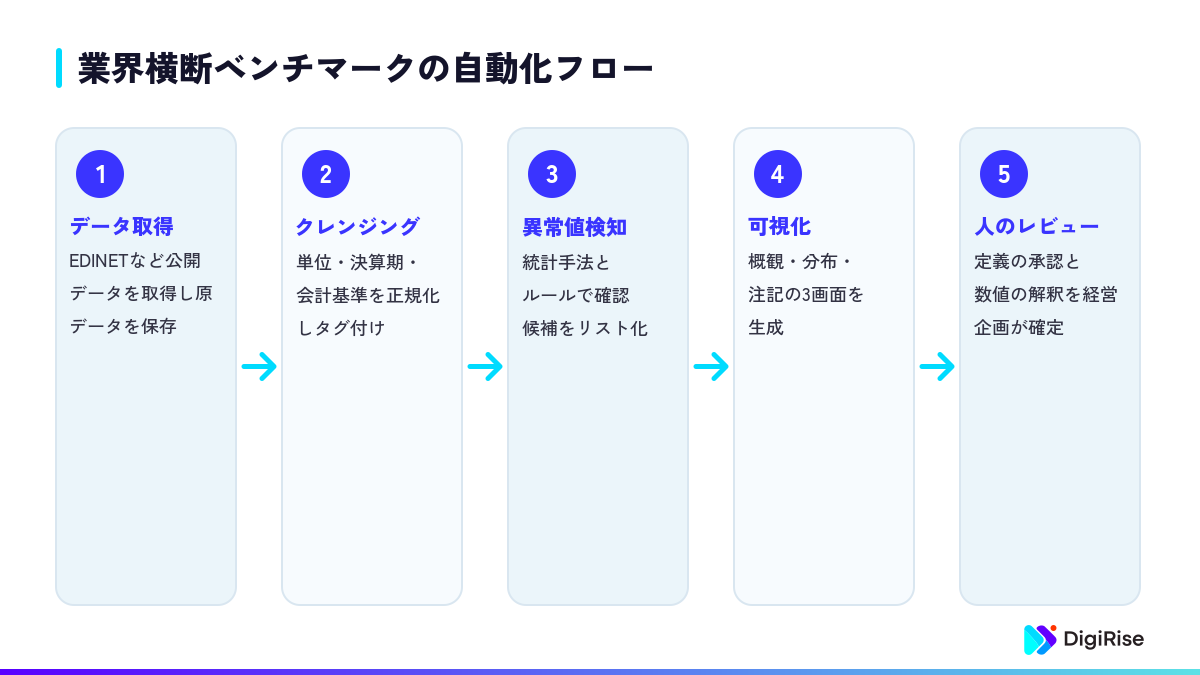
Claude Code はターミナル上で動くエージェント型のツールです。公式ドキュメントの How Claude Code works では、コーディングに限らずコマンドラインでできる作業全般を手伝えることが説明されています。作業は「コンテキストの収集・実行・結果の検証」の3段階を繰り返して進みます。ベンチマーク業務では、データ取得スクリプトの作成、整形処理、検知ロジックの実装、ダッシュボードのコード生成を任せられます。自分で毎回手を動かすというより、「再現可能なパイプラインを書いて実行させる」使い方が中心です。
競合企業の動向を継続的に追う仕組みについては、Claude Code で競合インテリジェンスを仕組み化する方法で詳しく扱っています。本記事は、その中でも定量比較の部分に絞って説明します。
公開データソースの選定とクレンジング
データソースを選ぶ判断基準
業界横断ベンチマークの土台は、誰でも検証できる公開データです。国内上場企業の財務情報なら、金融庁の電子開示システム EDINET に有価証券報告書などが XBRL 形式で掲載されており、API での取得手段も用意されています。米国企業なら SEC の EDGAR が提出書類と XBRL 財務データを公開しています。マクロ統計や産業統計を背景データに使う場合は、政府統計の総合窓口 e-Stat に API 機能があります。総務省の報道資料「統計データにおけるAPI機能の試行運用開始」は、API でできることを2つ挙げています。利用者の情報システムに e-Stat のデータを自動で反映すること、そして利用者が持つデータと連動させて分析することです。
各 API の利用条件、リクエスト数の制限、認証の要否は、必ず各機関の公式サイトにある最新の仕様書で確認してください。たとえば総務省統計局・統計センターの資料「API機能の概要と活用事例」は平成25年(2013年)時点のものです。この資料には、API で使える統計データは e-Stat 上で「DB」表示のあるデータだと書かれています。ただし、現在の仕様は最新版で確かめる必要があります。仕様は改訂されることがあるため、取得スクリプトの冒頭に「確認した仕様書の版と確認日」をコメントで残しておく運用をおすすめします。
| データ種別 | 代表的な公開ソース | 向いている用途 | 注意点 |
|---|---|---|---|
| 国内財務 | EDINET(有価証券報告書等) | 財務比率、セグメント比較 | タクソノミの版の違い、訂正報告書の扱い |
| 米国財務 | SEC EDGAR | 海外同業・異業種との比較 | 米国基準とIFRS・日本基準の差異 |
| マクロ・産業統計 | e-Stat | 業界平均や市場規模の背景データ | 統計ごとに調査周期・定義が異なる |
| ESG・人的資本 | 有価証券報告書のサステナビリティ記載、統合報告書 | 開示指標の対比 | 算定範囲・算定方法が企業ごとに異なる |
| 外部ESGスコア | 評価機関のスコア | 参考情報としての位置づけ | 評価手法の違い、ライセンス条件 |
ESGについては、評価機関のスコアをそのまま並べるのはおすすめしません。評価機関ごとに手法や重み付けが違い、同じ企業でも評価が大きく分かれることがあるためです。また、商用スコアには再配布や社内共有の範囲に制約があることも多く、契約条件の確認が先です。実務上は、企業が自ら開示している生の指標(排出量、女性管理職比率など)を軸にし、外部スコアは補助的な参考情報にとどめるほうが説明しやすくなります。
指標定義を標準化する
クレンジングで一番大事なのは、コードを書く前に指標定義を文書で固めることです。たとえばROEひとつでも、分母の自己資本を期末値にするか期首期末平均にするか、非支配株主持分を含めるかで値が変わります。
| 指標 | 標準定義の例(社内で決める) | よくあるブレ |
|---|---|---|
| ROE | 親会社株主に帰属する当期純利益 ÷ 期首期末平均の自己資本 | 期末値を使う、純資産全体を使う |
| ROA | 当期純利益(または事業利益)÷ 期首期末平均の総資産 | 分子の利益概念が統一されていない |
| 営業利益率 | 営業利益 ÷ 売上高 | IFRS では営業利益の範囲が企業ごとに異なる |
| ROIC | 税引後営業利益 ÷ 投下資本 | 投下資本の定義が企業ごとにバラバラ |
| 自己資本比率 | 自己資本 ÷ 総資産 | 純資産と自己資本の混同 |
決めた定義は CLAUDE.md に書いておきます。Claude Code 公式ドキュメントの概要ページによると、CLAUDE.md はプロジェクトのルートに置く Markdown ファイルで、Claude Code が毎セッションの開始時に読み込みます。/init コマンドで雛形を作ることもできます。以下は記載例です。
# ベンチマーク分析の前提
- ROE の分母は期首期末平均の自己資本。純資産は使わない
- 金額は百万円単位に統一。外貨は各社決算期末の為替レートで換算し、使用レートを記録する
- 決算期が異なる企業は「直近に終了した会計年度」で比較し、期ズレを一覧に明記する
- 定義を変えるときは必ず人の承認を得て、変更履歴を docs/definitions.md に残す
クレンジングの手順
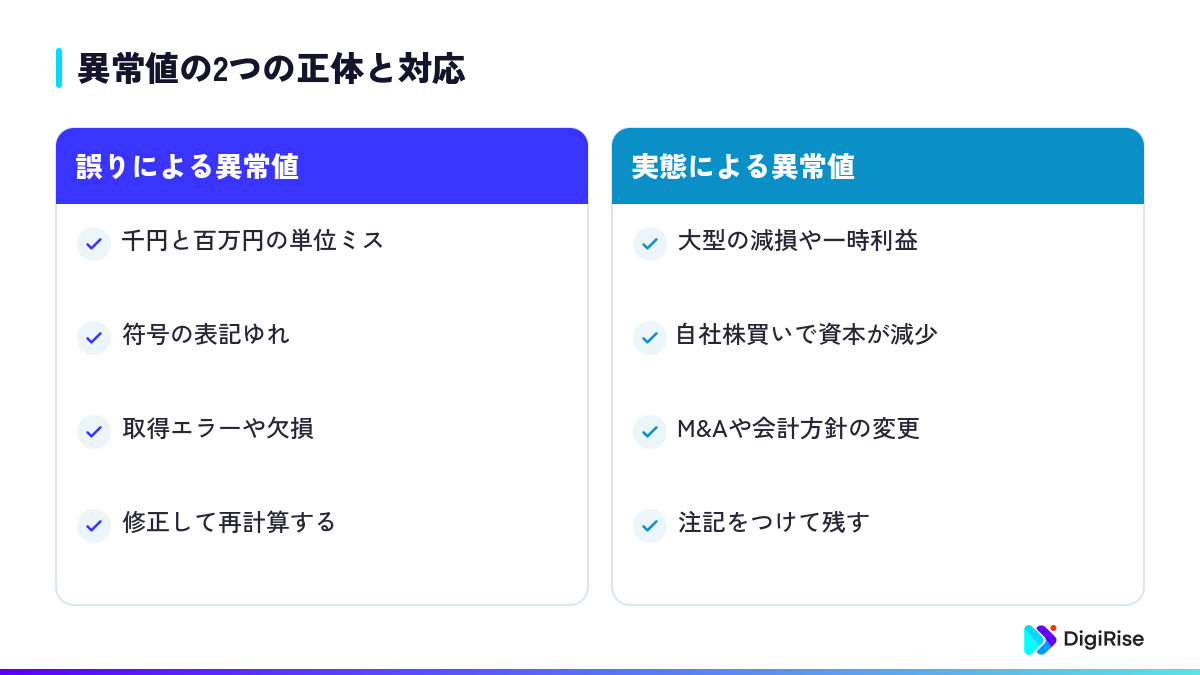
1. 単位と符号をそろえる — 千円・百万円の混在、損失のマイナス表記ゆれを統一します。単位ミスは異常値の原因として特に多い項目です。
2. 決算期と会計基準をタグ付けする — 各レコードに決算期末日と適用会計基準を持たせ、比較表で常に見えるようにします。
3. 欠損を区別する — 「開示なし」「該当なし」「取得失敗」を別々の値で記録します。全部を空欄にすると、後で原因を追えません。
4. 原データと加工データを分けて保存する — 取得したままの原データは書き換えず、加工後のデータを別に出力します。これで検証可能性を保てます。
異常値検知と可視化ダッシュボードの生成
異常値検知の代表的な手法
業界横断のデータには、入力ミスや取得エラーと、実態として突出している企業の両方が混ざります。異常値検知の目的は、自動で除外することではありません。「人が確認すべき候補をリスト化する」ことが目的です。
| 手法 | 仕組みの概要 | 向いている場面 | 留意点 |
|---|---|---|---|
| 四分位範囲(IQR) | 四分位の幅から外れた値を候補にする | 分布が偏った財務比率 | サンプルが少ないと不安定 |
| ロバストZスコア(中央値・MAD) | 中央値からの離れ具合を測る | 極端な値に引っ張られたくない場合 | 業種ごとに分けて計算する |
| 前年比の急変 | 前期からの変化率で検知 | 単位ミスや定義変更の発見 | M&Aや会計方針変更でも反応する |
| ルールベース | 自己資本比率が100%超など、あり得ない値を検知 | 明らかな誤りの発見 | ルールの網羅には限界がある |
Claude Code には、たとえば次のように指示します。「業種区分ごとにロバストZスコアを計算し、絶対値が閾値を超えた企業と指標を一覧化してください。各候補には、前年値・単位・会計基準・原データのファイルパスを併記してください」。閾値は最初から決め打ちせず、何回か出力を見ながら社内で調整していくのが現実的です。
検知結果を読むときの留意点
異常値と判定された企業が、実はベンチマークとして一番参考になる企業であることも珍しくありません。大型の減損、事業売却による一時利益、自社株買いによる自己資本の減少は、どれもROEなどを大きく動かします。
ダッシュボードとレポートの自動生成
可視化では、Claude Code に Python の可視化ライブラリやBIツール向けのデータ出力を書かせ、静的なHTMLダッシュボードや定型グラフを生成させる方法が扱いやすいです。私が推奨する構成は次の3画面です。
- 概観: 主要KPIを自社・同業平均・異業種ベンチマークで並べた一覧
- 分布: 業種別の箱ひげ図に自社の位置を重ねた図
- 注記: 期ズレ・会計基準・欠損・除外企業とその理由の一覧
なかでも注記画面は省略されがちです。しかし、経営会議で「この比較は前提が違うのでは」と質問されたときにすぐ答えられるかどうかは、この画面で決まります。経営層向けレポートへの落とし込み方は、Claude Code で経営レポーティングを効率化する方法で整理しています。業界別のベンチマーク設計の基本は、Claude Code 業界ベンチマーク分析の進め方も参考にしてください。
企業で使うなら:導入時の注意点と判断材料
権限とデータの扱い
Claude Code はファイル操作やコマンド実行ができる分、権限設計が重要になります。公式ドキュメントの Configure permissions によると、権限ルールには許可(allow)・確認(ask)・拒否(deny)の3種類があります。どこかの階層で拒否されたツールは、他の階層では許可できません。組織が配布する管理設定(managed settings)が最も優先され、コマンドライン引数でも上書きできないとされています。設定ファイルの置き場所と優先順位は Settings files and precedence にまとまっています。
Security のページには、手動モードの Claude Code は読み取り専用の権限から始まると書かれています。curl や wget のようなネットワークコマンドは既定で確認を求め、実行させたくない場合は deny に加えられます。ベンチマーク用のプロジェクトでは、たとえば次のような設定から検討するとよいでしょう。
{
  "permissions": {
    "ask": ["Bash(curl *)", "Bash(wget *)"],
    "deny": ["Read(./.env)", "Read(./secrets/**)"]
  }
}
ただし Best practices には、ファイルの読み取り拒否ルールではスクリプトの中からファイルを開く処理までは防げない、という注意があります。データ取得スクリプトを自動で動かすベンチマーク業務では、サンドボックス(/sandbox)の併用も検討してください。サンドボックスは、ファイルやネットワークへのアクセスを OS のレベルで制限する仕組みです。原データのディレクトリを保護したい場合も、権限ルールだけに頼らず、保存場所のアクセス権とあわせて設計するのが安全です。
データの扱いで特に注意したいのが、公開データと社内の未公表数値を混ぜるケースです。決算発表前の自社数値をベンチマークに入れる場合、その作業環境は未公表の重要情報を扱う環境になります。インサイダー情報管理やフェア・ディスクロージャーの社内規程と照らして、作業者・保存場所・出力物の共有範囲を決めておく必要があります。公式の Data usage には、セッションの会話履歴が既定でローカルの ~/.claude/projects/ に平文で一定期間保存されると記載されています。また、Claude for Enterprise の対象アカウントでは、組織単位でゼロデータ保持(ZDR)を有効にできる場合があるとされています。社内規程を決める前に、これらの記載を情報システム部門と一緒に確認してください。
体制と費用の考え方
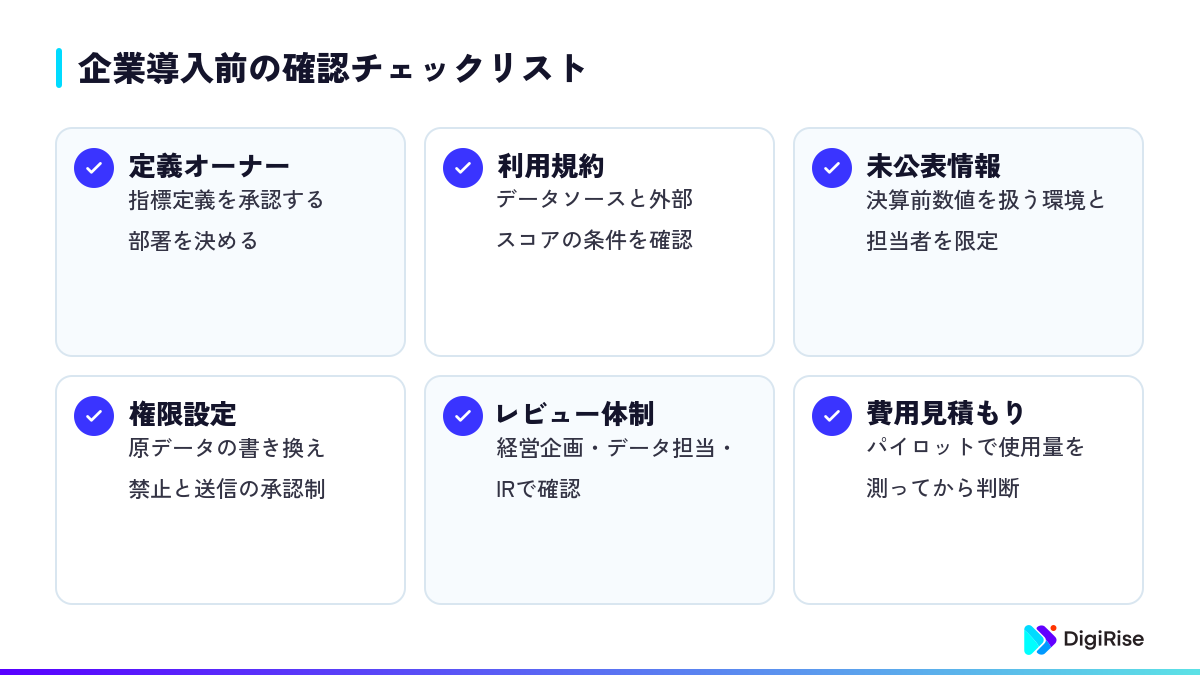
| 確認項目 | 判断のポイント |
|---|---|
| 指標定義のオーナー | 経営企画か財務企画のどちらが承認するかを決めているか |
| データ利用規約 | 各データソース・外部スコアの利用条件と社内共有範囲を確認したか |
| 未公表情報の扱い | 決算前数値を扱う環境と担当者を限定しているか |
| 権限設定 | 原データの書き換え禁止、外部送信の承認制を設定したか |
| レビュー体制 | 異常値候補と最終レポートを誰が確認するかが決まっているか |
| 費用 | 利用プランや API 従量課金を、更新頻度と対象社数から見積もったか |
体制としては、経営企画(定義と解釈)、データ担当(パイプラインの保守)、IR(開示との整合確認)の3者でレビューする形が回しやすいと考えています。費用の考え方は契約形態で変わります。公式の Manage costs effectively によると、Teams・Enterprise プランでは各メンバーのシート枠から利用量が差し引かれます。Claude Console やクラウドプロバイダー経由の場合は、トークン単位で組織に課金されます。セッション中の使用量は /usage コマンドで確認できます。まず対象を数十社・主要指標に絞ったパイロットで実際の使用量を測り、本格展開の可否を判断するのが堅実です。
注意: ベンチマークの数値は、定義・期間・母集団の取り方で変わる参考値です。対外的な説明やIR資料に使う場合は、算出方法と前提を必ず併記し、社内の開示レビューを通してください。
Q. 有料のデータベースを契約していなくても業界横断ベンチマークはできますか?
できます。EDINET、SEC EDGAR、e-Stat などの公開データだけでも、主要な財務比率の業界横断比較は組み立てられます。ただし、XBRL の項目の対応付けや期ズレの補正には手間がかかるので、最初は対象企業と指標を絞って始めるのが現実的です。
Q. 外部の ESG スコアをダッシュボードに載せてもよいですか?
まず評価機関との契約で、社内共有や加工の範囲が許されているかを確認してください。評価機関によって手法が異なるため、スコアを並べるだけでは結論を出しにくい点にも注意が必要です。企業の開示している生の指標を軸にし、外部スコアは参考情報として扱うことをおすすめします。
Q. 異常値と判定された企業は比較対象から外すべきですか?
自動で外すべきではありません。単位ミスなどの誤りなら修正し、減損や事業売却などの実態による変動なら注記をつけて残します。除外する場合も、その企業と理由をダッシュボードの注記画面に記録してください。
Q. Claude Code の出力した数値をそのまま経営会議で使ってよいですか?
原データとの突き合わせと、指標定義どおりに計算されているかの確認を経てから使ってください。原データと加工データを分けて保存し、計算過程を追える状態にしておけば、レビューの手間は小さくなります。最終的な解釈と結論は、経営企画が責任を持って確定させる運用が前提です。
まとめ
- 業界横断ベンチマークで Claude Code に任せるのは、取得・整形・異常値検知・可視化の下書きまでです。定義の承認と解釈は人が持ちます。
- データソースは EDINET・SEC EDGAR・e-Stat などの公開データを軸にし、利用条件と仕様は公式資料で確認します。
- ROE や ROIC などは社内で標準定義を決め、CLAUDE.md に書いてブレを防ぎます。
- 異常値は自動で除外せず、確認候補としてリスト化し、注記とセットで扱います。
- 企業での導入では、権限設計・未公表情報の管理・レビュー体制を先に決め、パイロットで費用感を測ります。
自社に合うパイプライン設計や社内規程の整備から相談したい場合は、デジライズの Claude Code 法人導入支援をご利用ください。現場担当者向けの研修と、業務設計・ガバナンス整備のコンサルティングの2本柱でご支援しています。無料相談も受け付けているので、まずは現状の業務フローをお聞かせください。
出典・参考資料
- Overview - Claude Code Docs
- How Claude Code works - Claude Code Docs
- Configure permissions - Claude Code Docs
- Settings files and precedence - Claude Code Docs
- Security - Claude Code Docs
- Best practices for Claude Code - Claude Code Docs
- Data usage - Claude Code Docs
- Manage costs effectively - Claude Code Docs
- 総務省 報道資料「統計データにおけるAPI機能の試行運用開始」
- 総務省統計局・独立行政法人統計センター「API機能の概要と活用事例」(平成25年6月)
関連記事
デジライズの実績は社内集計値です。特に明記のない数値付き事例は、匿名加工された実例をもとにしたモデルケースです。導入効果は企業や業務によって異なります。各サービスの料金・機能・提供条件は記事の公開・更新時点の情報であり、変更されるため、最新情報はAnthropic公式サイトなどの一次情報をご確認ください。
Claude Codeの法人導入・研修・業務活用を支援しています。
法人導入支援サービスを見る